AskManyAI
AskManyAI是一个集成了多种顶尖AI模型的多功能工具平台,该平台整合了超过10万个AI模型,覆盖了文本生成、图像处理、数据分析、语音合成等多种功能。
 MinerU
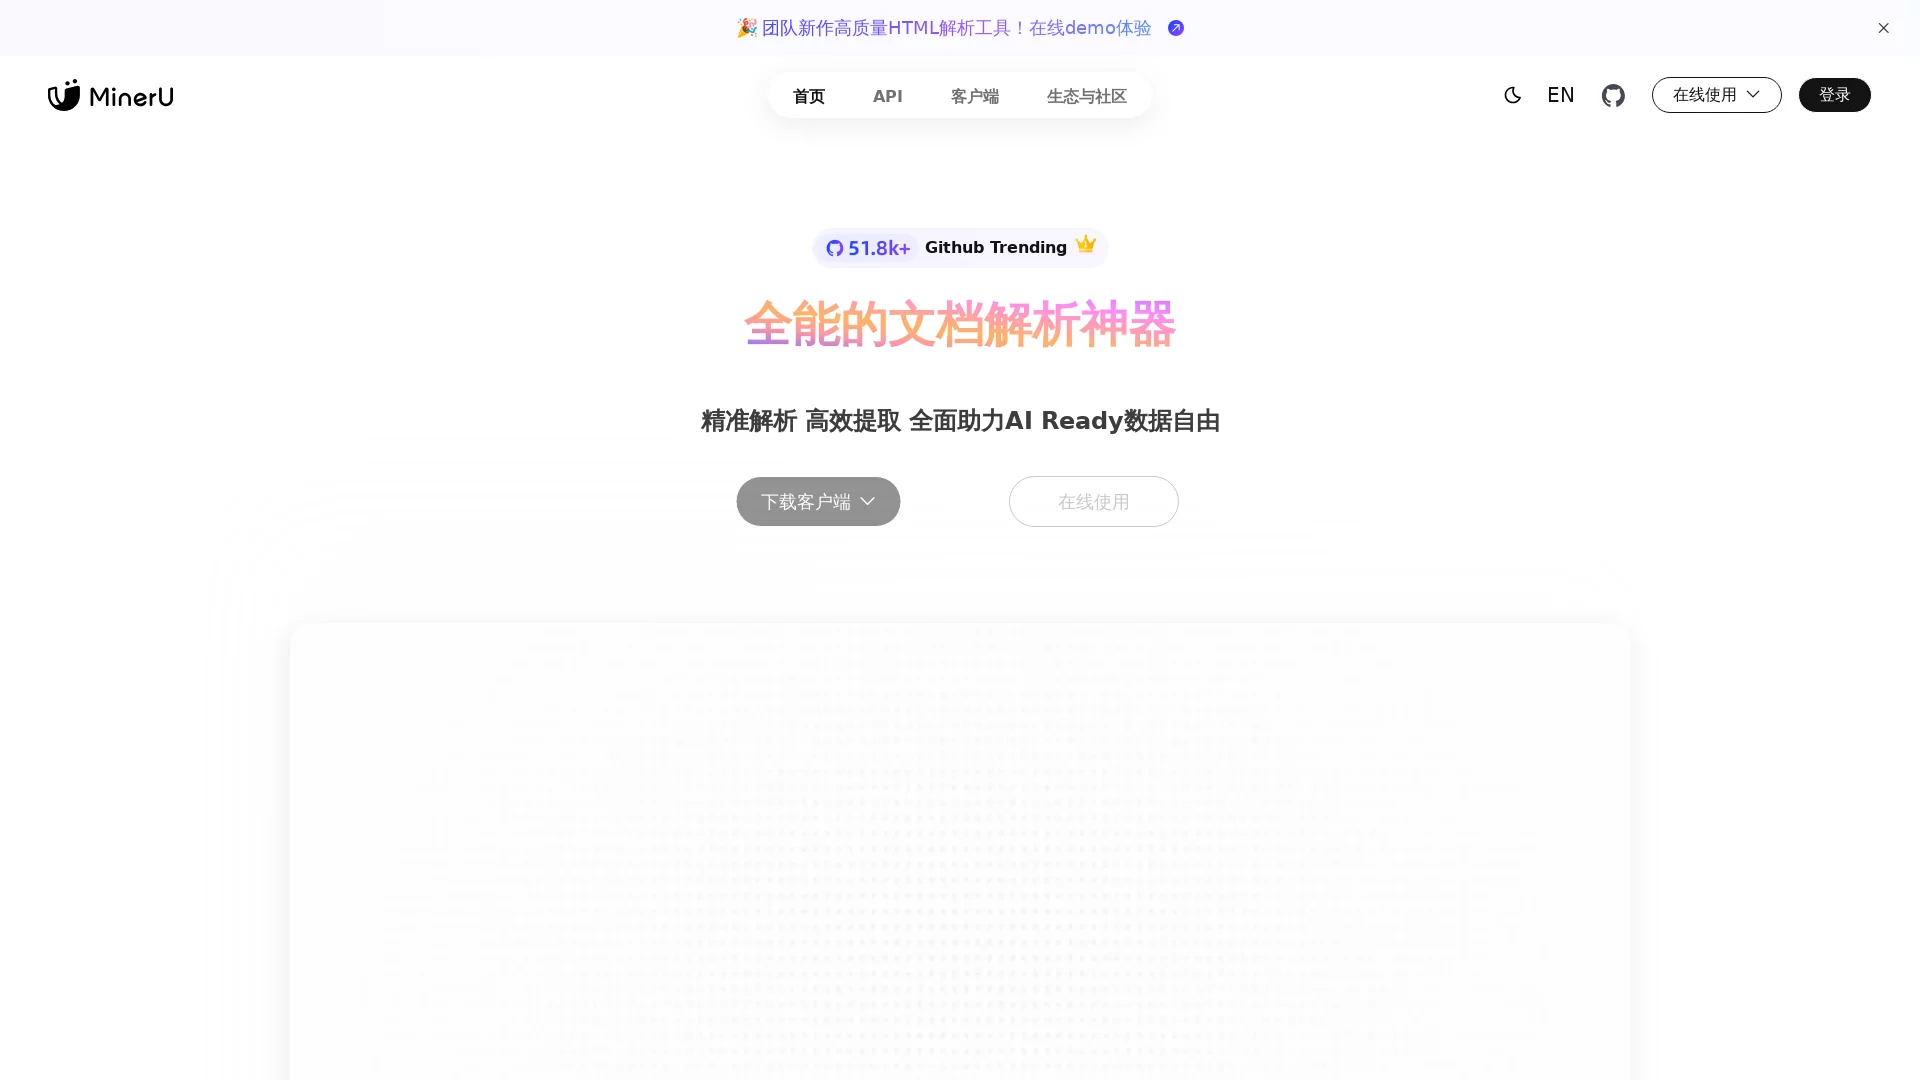
是一款由上海人工智能实验室OpenDataLab团队开发的开源高质量数据提取工具,旨在高效地从PDF文件、网页和多格式电子书中提取内容。
一份上百页的行业研报、一篇双栏排版的学术论文、一本格式杂乱的电子书——想把它们变成可编辑、可检索、可分析的数据,往往意味着大量复制粘贴和反复校对。MinerU 的出现,就是为了让这件事交给机器完成。这款由上海人工智能实验室(OpenDataLab)推出的开源智能数据提取工具,能够把 PDF、网页和电子书批量转换成 Markdown、JSON 等结构化格式,让文档从“人读”真正走向“机器可读”。
官方网址:https://mineru.net/
与常见的 OCR 工具不同,MinerU 并不满足于“把字认出来”。它围绕多模态文档解析构建了完整的处理链路,从版面分析、内容识别到结果组织,每一步都有精细处理,最终输出干净、结构清晰、可直接投入下游分析的内容。项目代码托管在 GitHub(https://github.com/opendatalab/MinerU),开源属性让任何人都能审查实现细节、参与共建,活跃的社区也是它区别于闭源工具的一大优势。
输出格式的选择其实很有讲究:Markdown 适合直接阅读、发布,或导入笔记软件与知识库;content.json 则把段落、表格、图片位置等结构信息拆解得清清楚楚,开发者拿到后可以直接在代码中对这些结构做二次加工。一个面向“人”,一个面向“程序”,两条路都铺好了。
MinerU 的能力由两个核心模块支撑,各自盯住一类文档来源,组合起来几乎能覆盖日常提取场景的全部需求。
学术论文的多栏排版、财务报告里的嵌套表格、理工教材中的公式推导,都是传统工具最容易“翻车”的地方。Magic-PDF 专注于 PDF 文档的高效解析,能识别并还原这些复杂版式中的结构信息,输出层次分明的 Markdown 文件,后续无论是编辑、检索,还是作为语料投喂给大语言模型,都省心不少。
网页内容结构松散、电子书格式各异,靠手工整理费时费力。Magic-Doc 面向这两类来源,能够从非结构化内容中提取有价值的信息,并支持多种格式的文档转换。做资料归档、内容聚合或搭建知识库时,它可以把大量机械性搬运工作压缩到几分钟内完成。
实用建议:拿不准提取效果时,先用在线 demo 试传一两份典型文档,确认输出质量符合预期后,再决定走客户端批量处理的路线,还是深入到源码部署的层面。
提取准确性靠什么保障?MinerU 背后依托上海人工智能实验室的模型研发能力,采用高质量的模型推理与多步精细处理流程,在提取的准确性与完整性上表现稳定,而不是简单的单次文字识别。
处理后的数据能用来做什么?常见去向包括:构建可检索的知识库、为大语言模型准备训练或检索语料、批量整理学术文献、归档财务与行业报告等。结构化的输出让这些下游任务省去了人工清洗的环节,从源头提升了数据准备的效率与质量。
适合哪些人?研究人员可以用它快速拆解论文与报告,内容运营者可以批量归档网页资料,开发者则能借助 JSON 输出把文档解析无缝接进自动化流程。对于任何一个被文档格式折磨过的人来说,把重复劳动交给工具、把时间留给真正的分析与创作,才是更划算的选择。